X-scraper 使用说明
微信公众号采集助手操作指南
本文介绍 X-scraper 的核心页面与常用流程,帮助你完成本地服务启动、公众号接入、关键词采集、微信公众号文章采集、公众号文章评论采集、任务追踪等。工具采集的数据可通过本地后台管理,也可通过 MCP 服务接入本地智能体或自建业务系统。新增通过微信读书采集公众号文章的通道。
1APP 启动服务
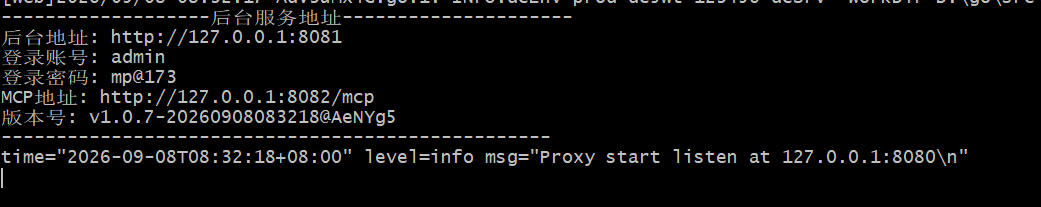
下载完成后,双击 app.exe 即可启动本地服务。启动成功后,浏览器访问 http://127.0.0.1:8081/,输入账号密码即可登录后台。
- 启动窗口会展示本地后台地址和 MCP 服务地址。
- 后台用于管理公众号、文章、评论、查看任务进度和调整系统配置。
- MCP 服务可集成到本地智能体中,让智能体直接调用已采集的文章数据。
2全局设置说明
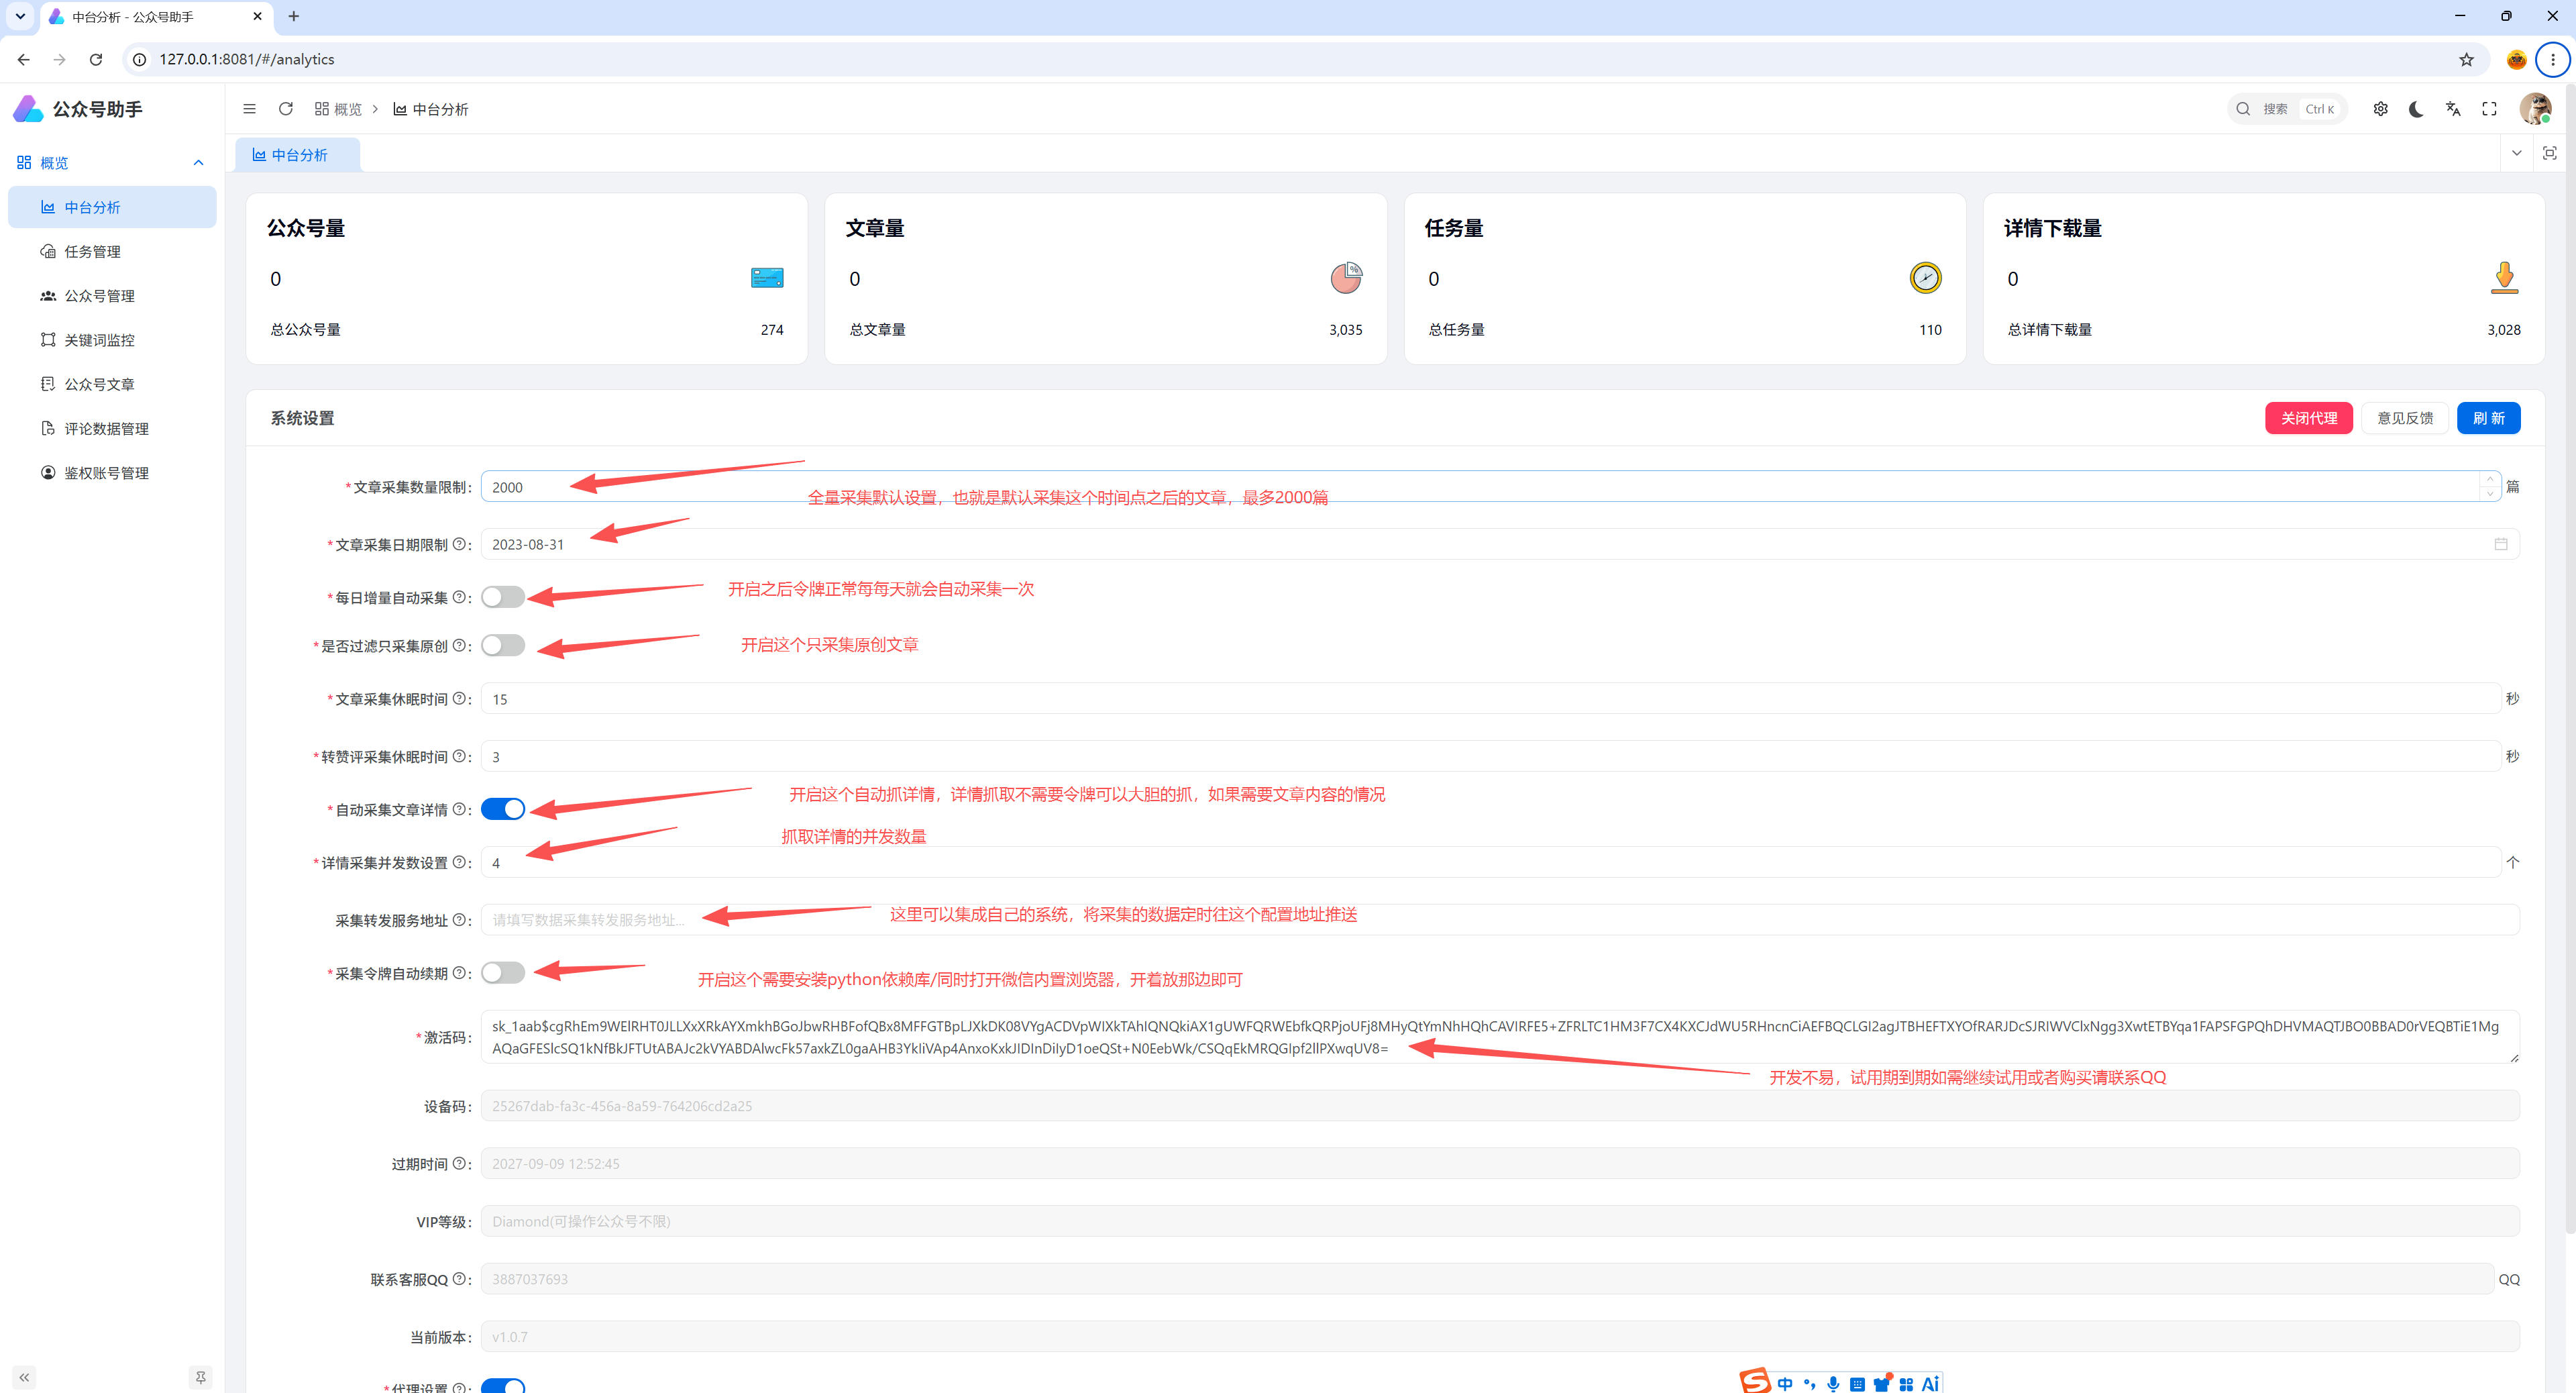
全局设置页面顶部会汇总当前 APP 的采集数据和运行状态,下方用于配置采集频率、VIP 自动能力和数据转发服务。
- 采集休眠时间:用于控制采集频率。每次请求接口后会按照设置值休眠,支持小数,例如
0.5s。 - VIP 自动服务:开通后可配置每日增量采集和微信令牌自动续期。当前微信令牌通常约 30 分钟到期;在微信内置浏览器保持打开时,APP 可自动唤醒并完成续期,减少人工介入。
- 采集转发服务地址:用于把采集到的数据推送到自建业务系统。接收方 HTTP 接口处理成功后需要明确返回
OK,否则 APP 会按周期重试。
3公众号管理与新增公众号
首次启动时,公众号列表通常为空。你可以通过微信内置浏览器访问目标公众号文章,让系统识别并加入公众号管理列表。旧的通过公众号主页API采集当前已经不可用,但是新增了一个通过微信读书的采集通道,如果遇到报错可以手机上安装一个微信读书,然后搜索一下公众号点击查阅一下,然后网页重新登录授权再试试.
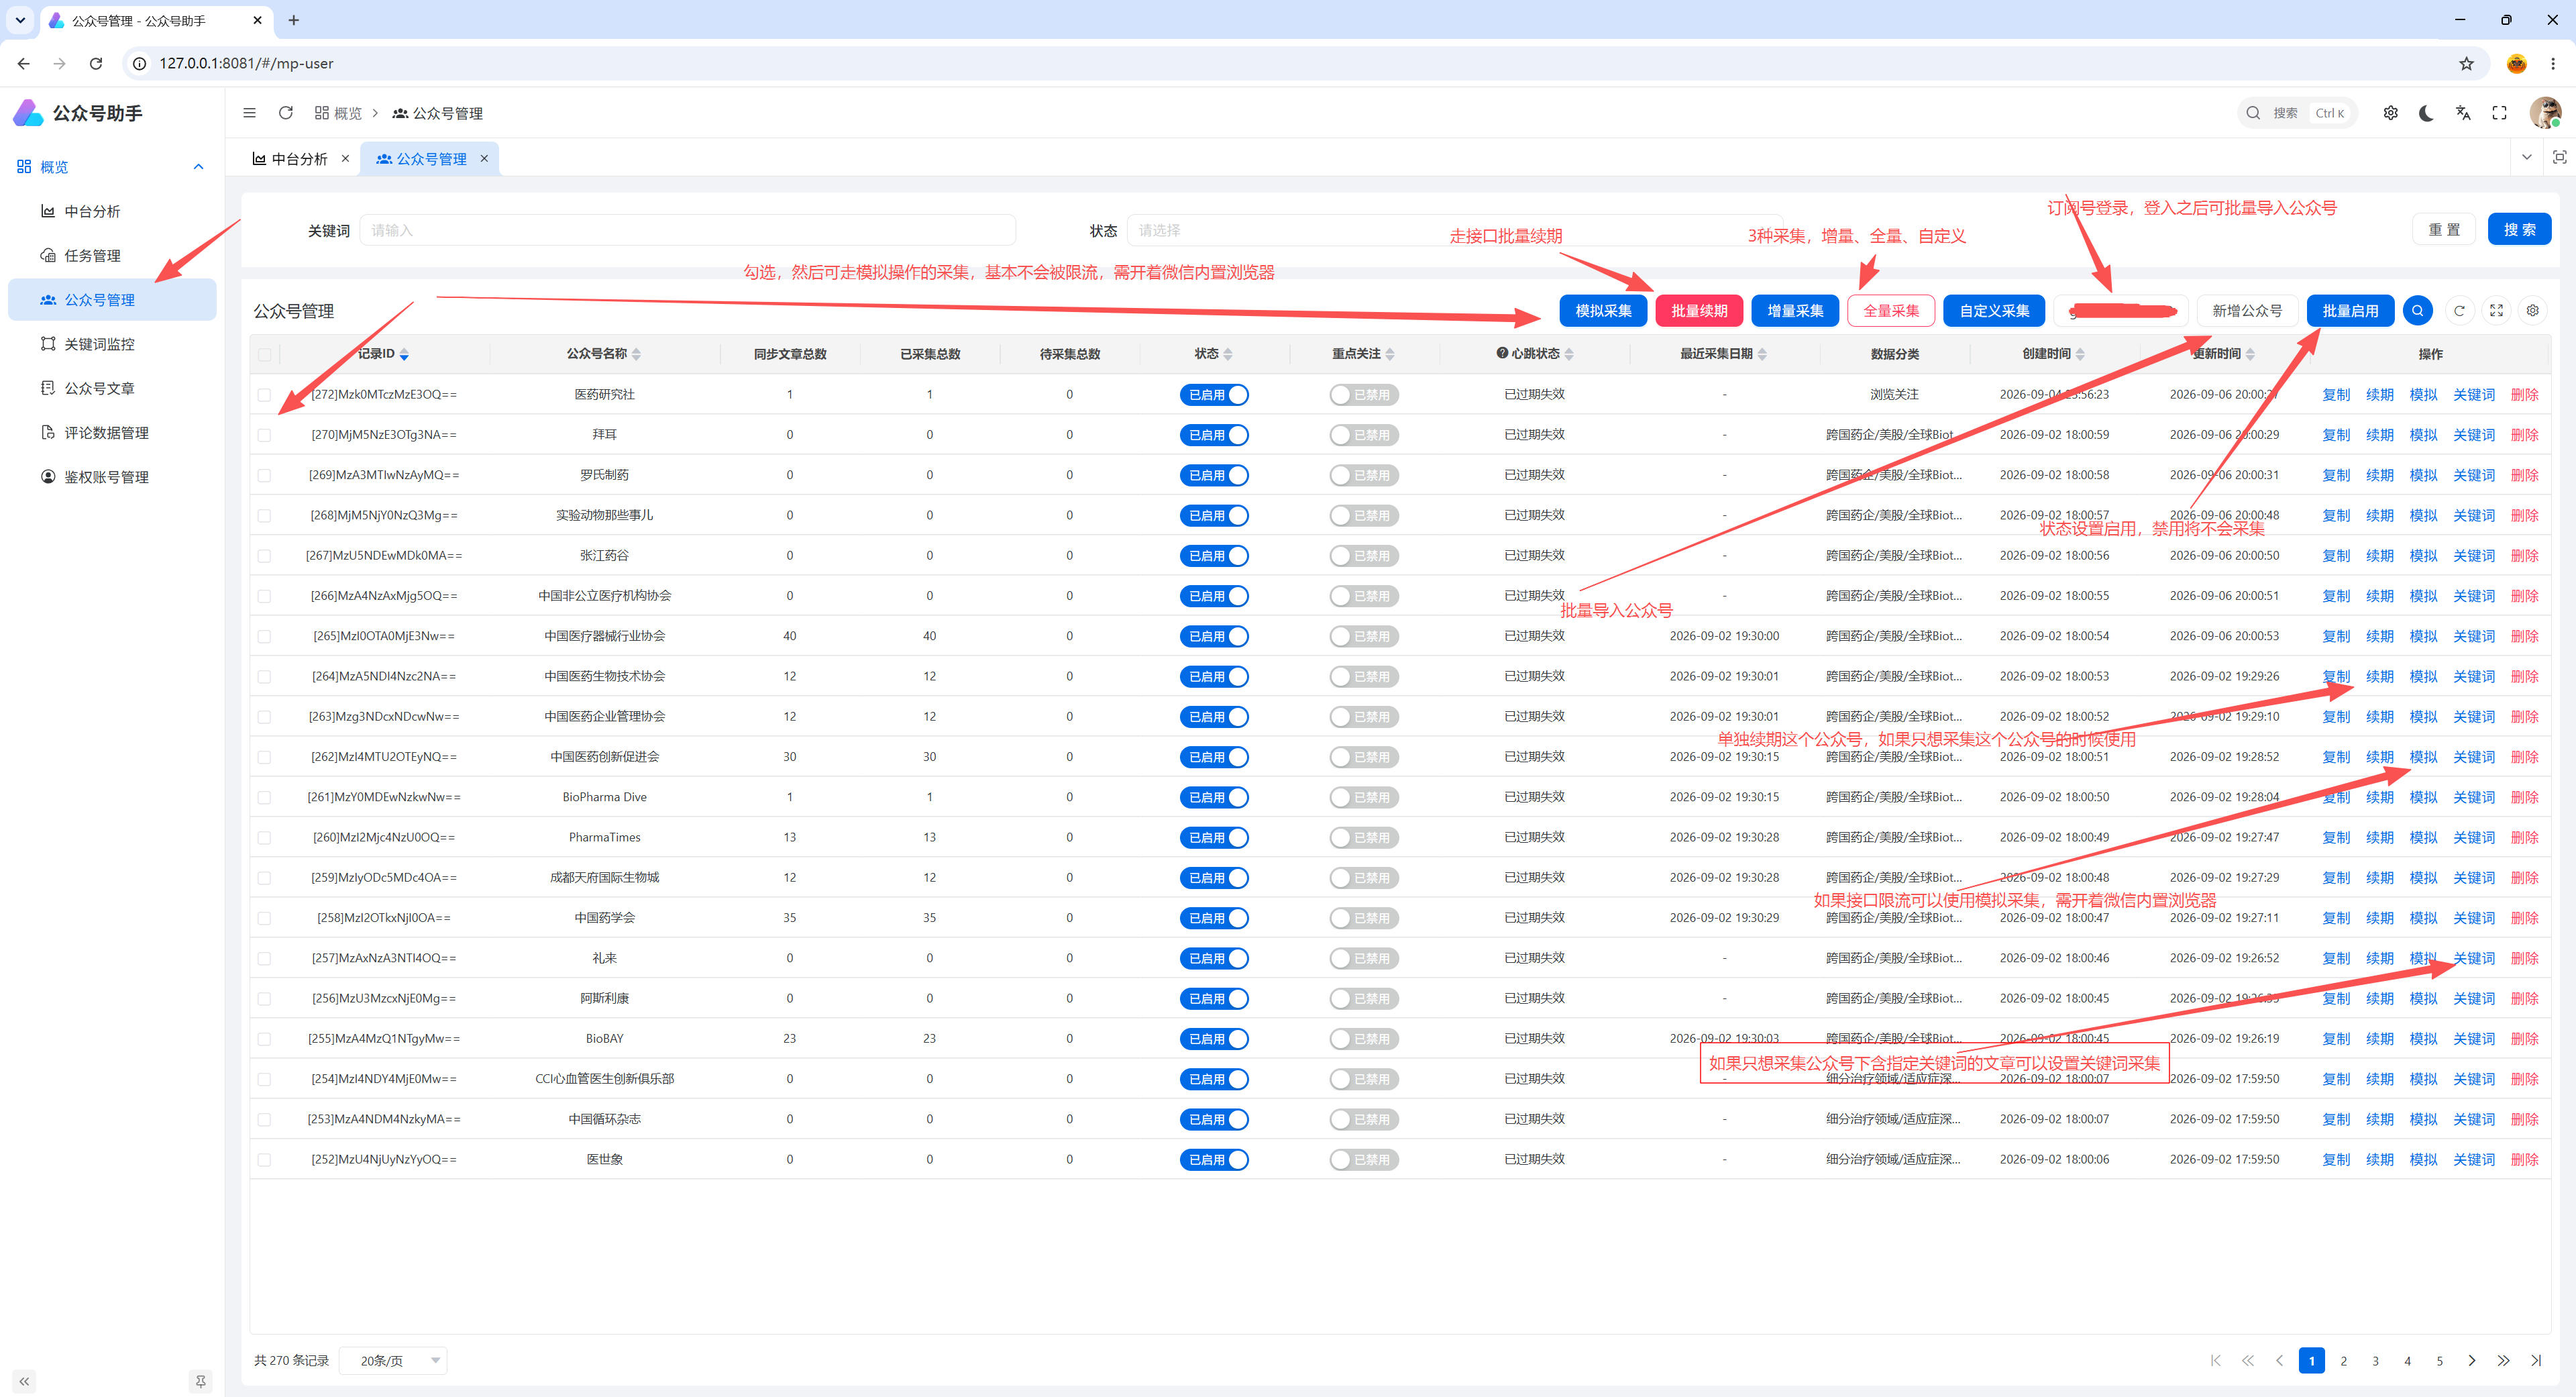
- 打开 PC 微信,进入目标公众号,任选一篇文章并在微信内置浏览器中打开,然后手动刷新页面。正常情况下,该公众号会出现在“公众号管理”中。
- 如果需要添加的公众号较多,可先登录订阅号,再使用“批量导入公众号”功能批量导入。
- 全量采集数据量较大时,请适当降低采集频率。微信端可能对账号限流;被限流后,可切换本地微信账号或等待限制解除。
- 多种采集模式集成,模拟采集就是模拟人工操作的采集行为,不容易被微信限流,关键词采集是只采集这个公众号下含指定关键词的文章
- 开启“重点关注”后,系统会定期检测目标公众号是否发布新文章。发现新内容并完成采集后,可通过已配置的 HTTP 接口通知业务系统。
4关键词采集管理
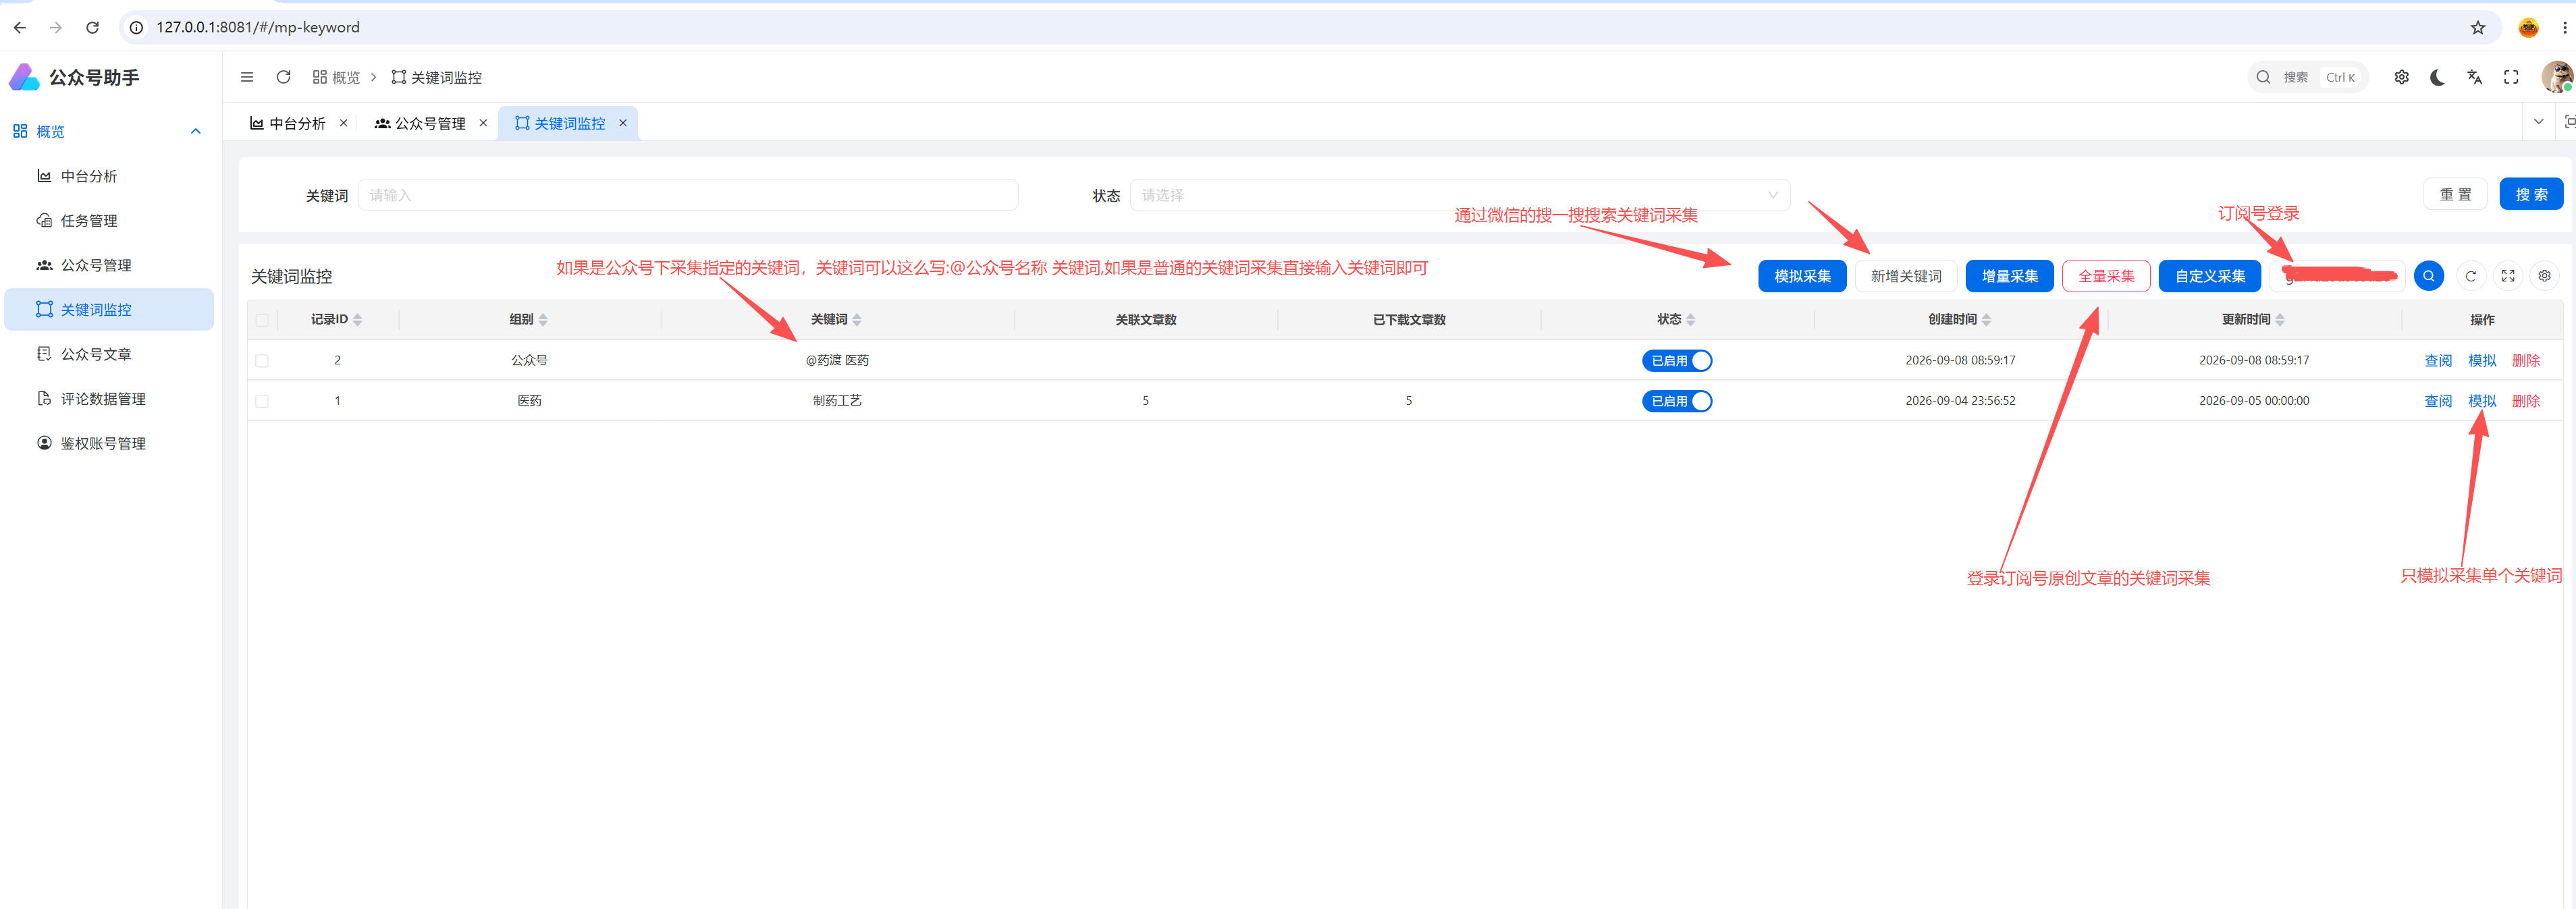
关键词采集用于按关键词检索公众号原创文章,该能力依赖公众号登录状态。通过关键词采集到的文章,部分字段可能需要后续补采才能完整展示。
- 关键词采集适合快速采集与主题相关的原创公众号文章.
- 模拟采集就是模拟用户行为自动化的关键词采集,以来安装python环境+打开微信内置浏览器;如果是采集公众号下的关键词可以这样子设置关键词:
@公众号名称 关键词
5公众号文章
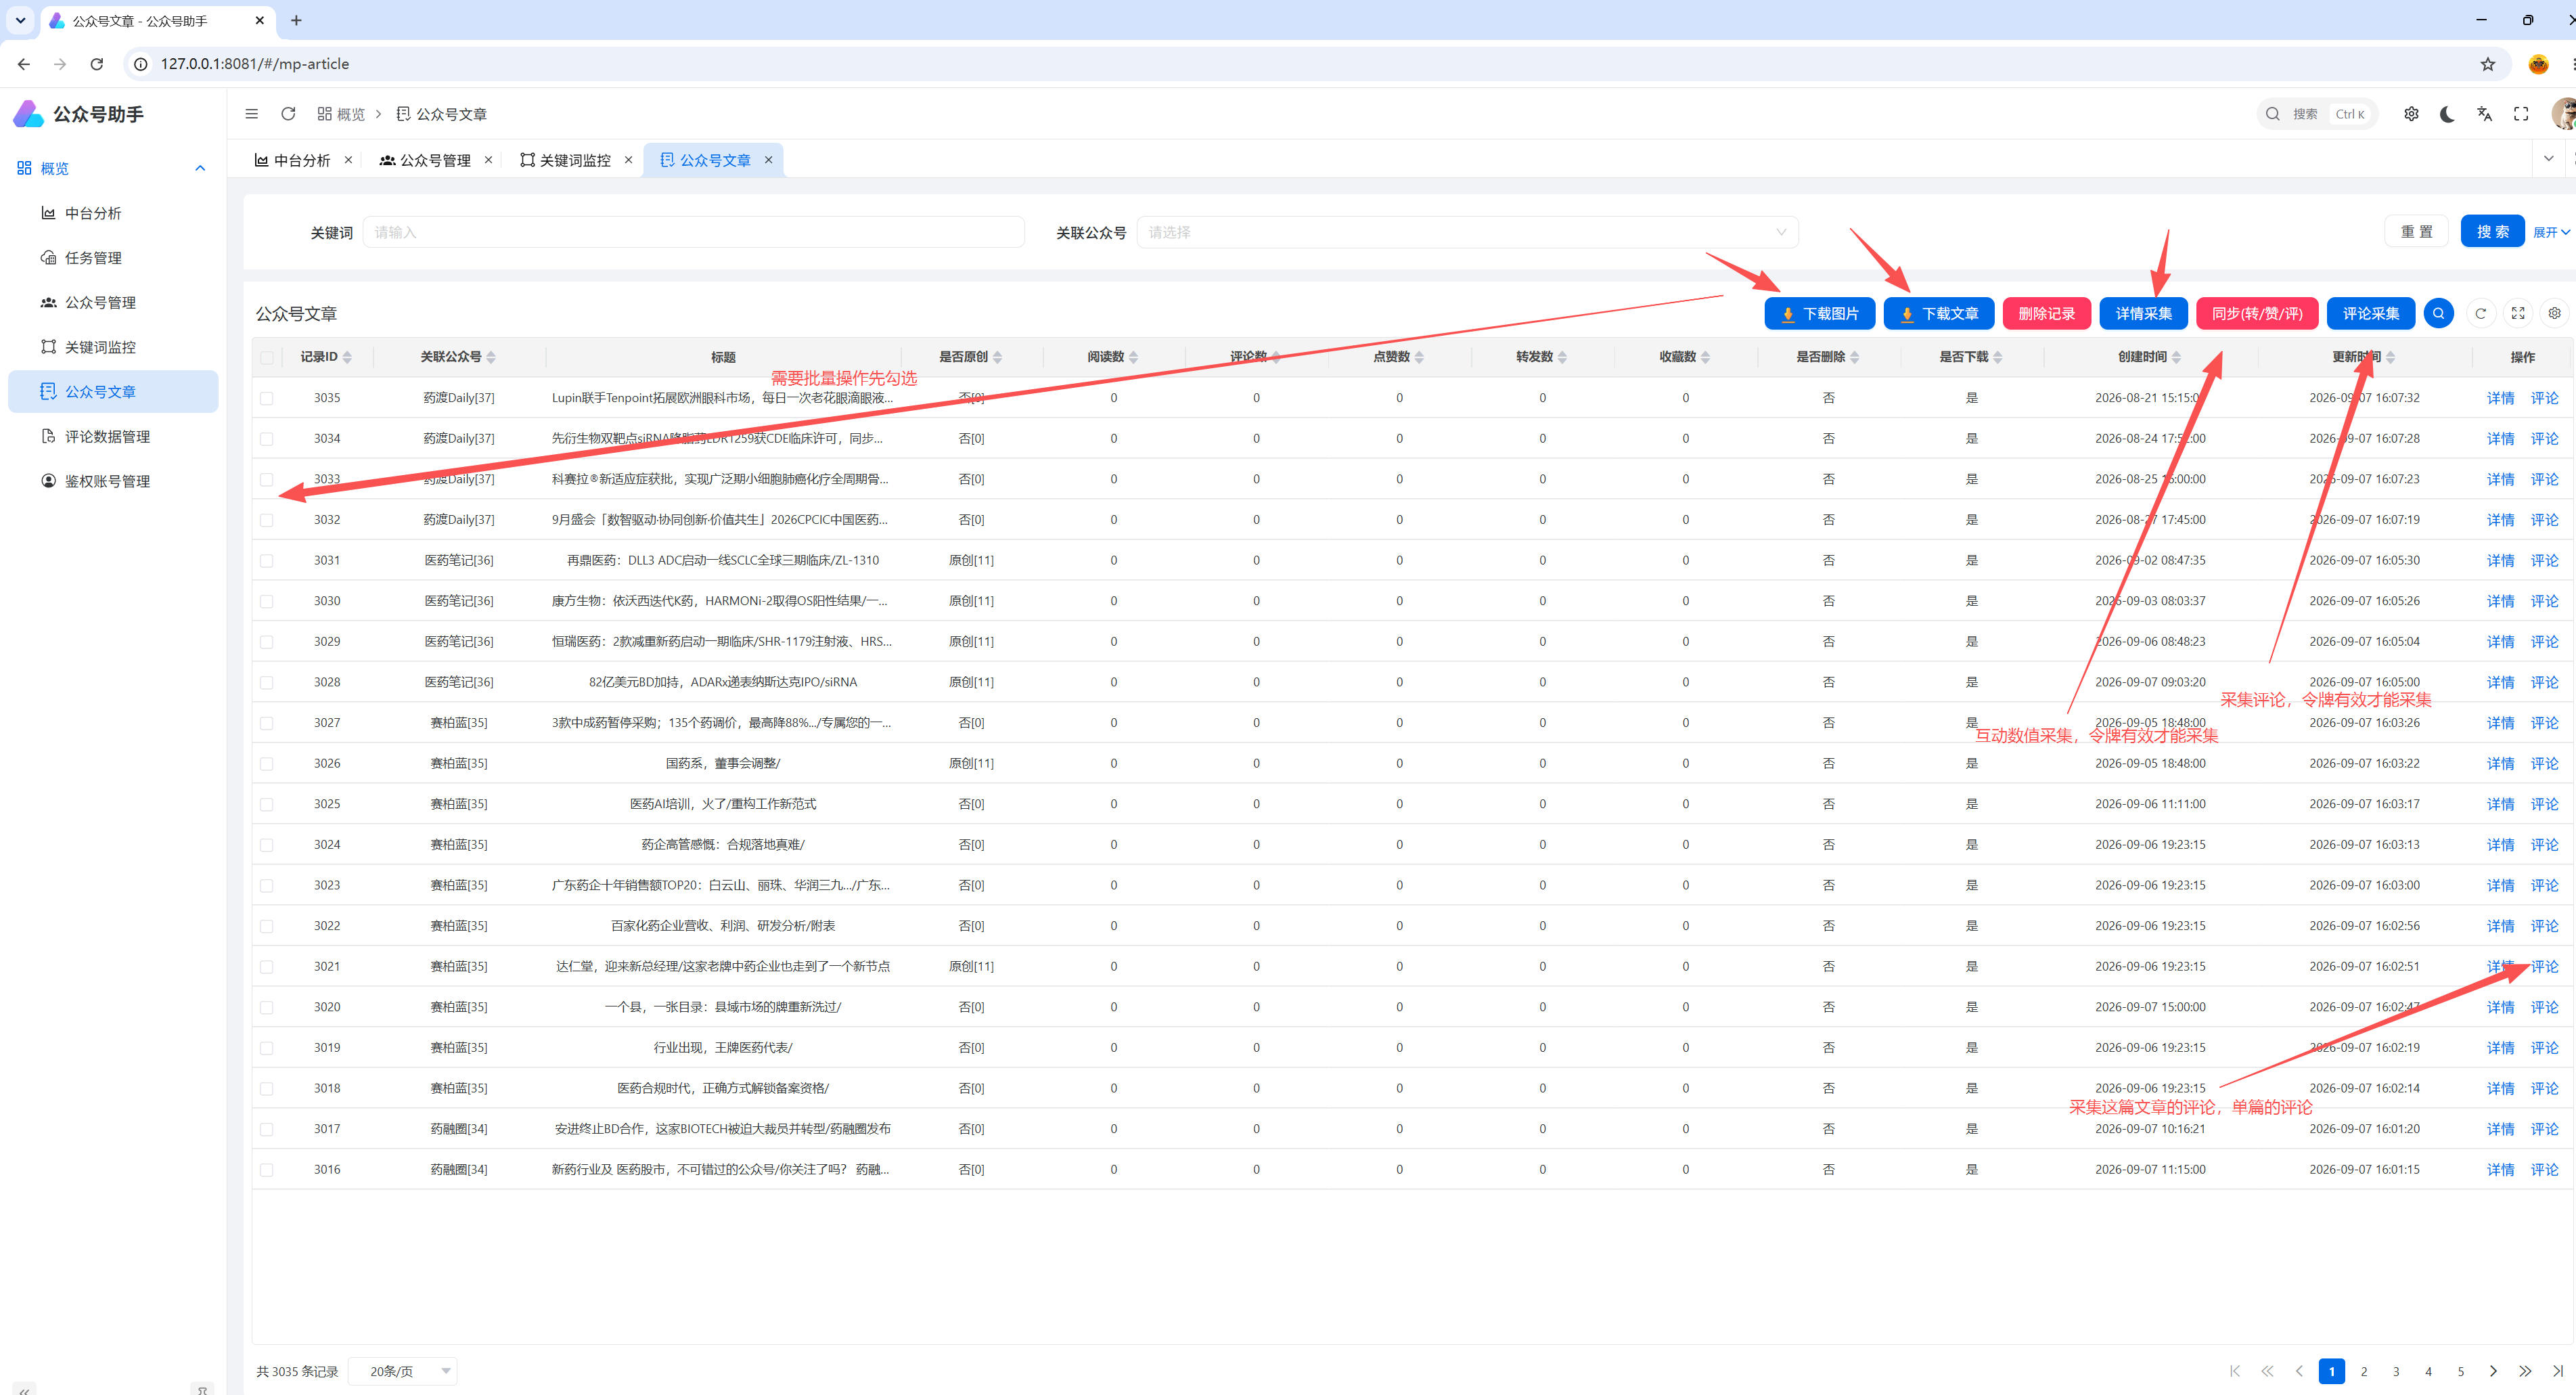
“公众号文章”页面会汇总公众号采集和关键词采集得到的所有文章。你可以在这里补采详情、更新统计数值,并继续管理文章数据。
- 需要正文、发布时间等信息时,请先执行“详情采集”。
- 需要评论数时,请先完成详情采集,再执行“转赞评采集”。
- 勾选指定的文章可以发起评论数据的抓取采集
- 转发、点赞、评论等统计数据的采集频率受全局设置影响;如果处理速度偏慢,可在全局设置中适当调整休眠时间。
6文章评论
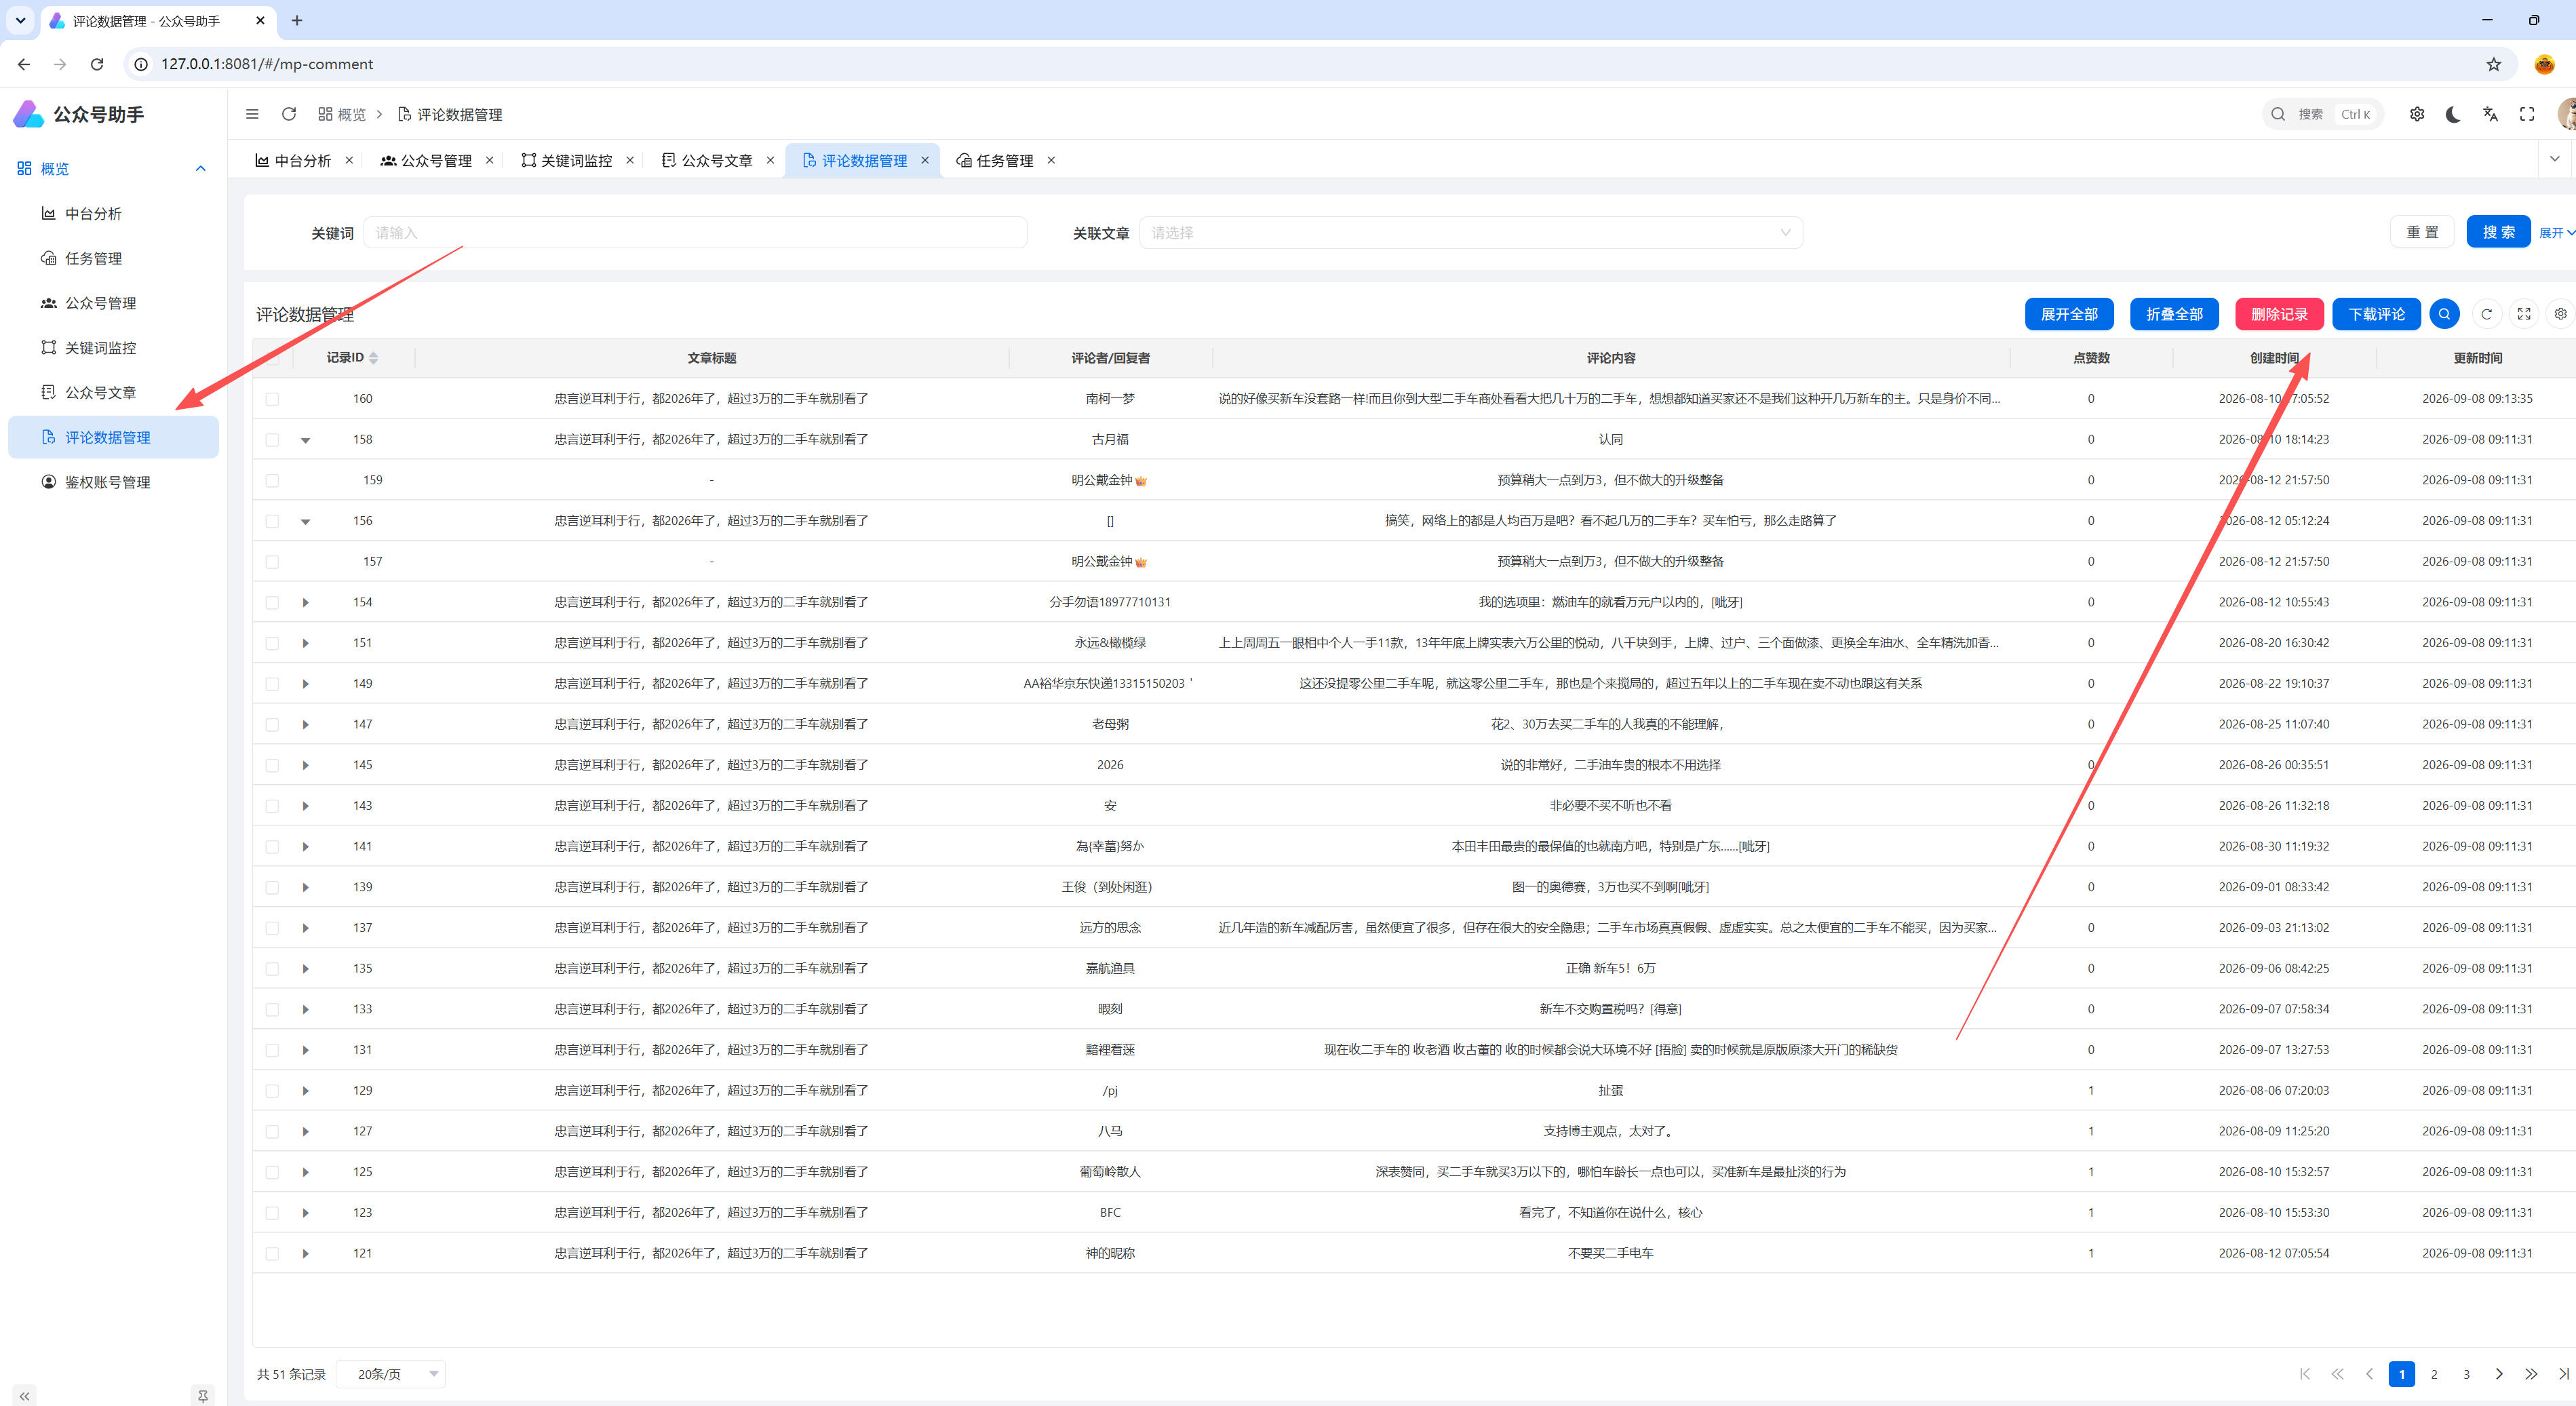
“文章评论”页面会汇总公众号所有文章评论的采集管理。
- 根据文章管理界面发起的采集,采集数据会汇总到这里
- 可以通过智能体接入本地的HTTP协议的MCP服务对采集的评论做进一步数据分析汇总整理
7任务管理
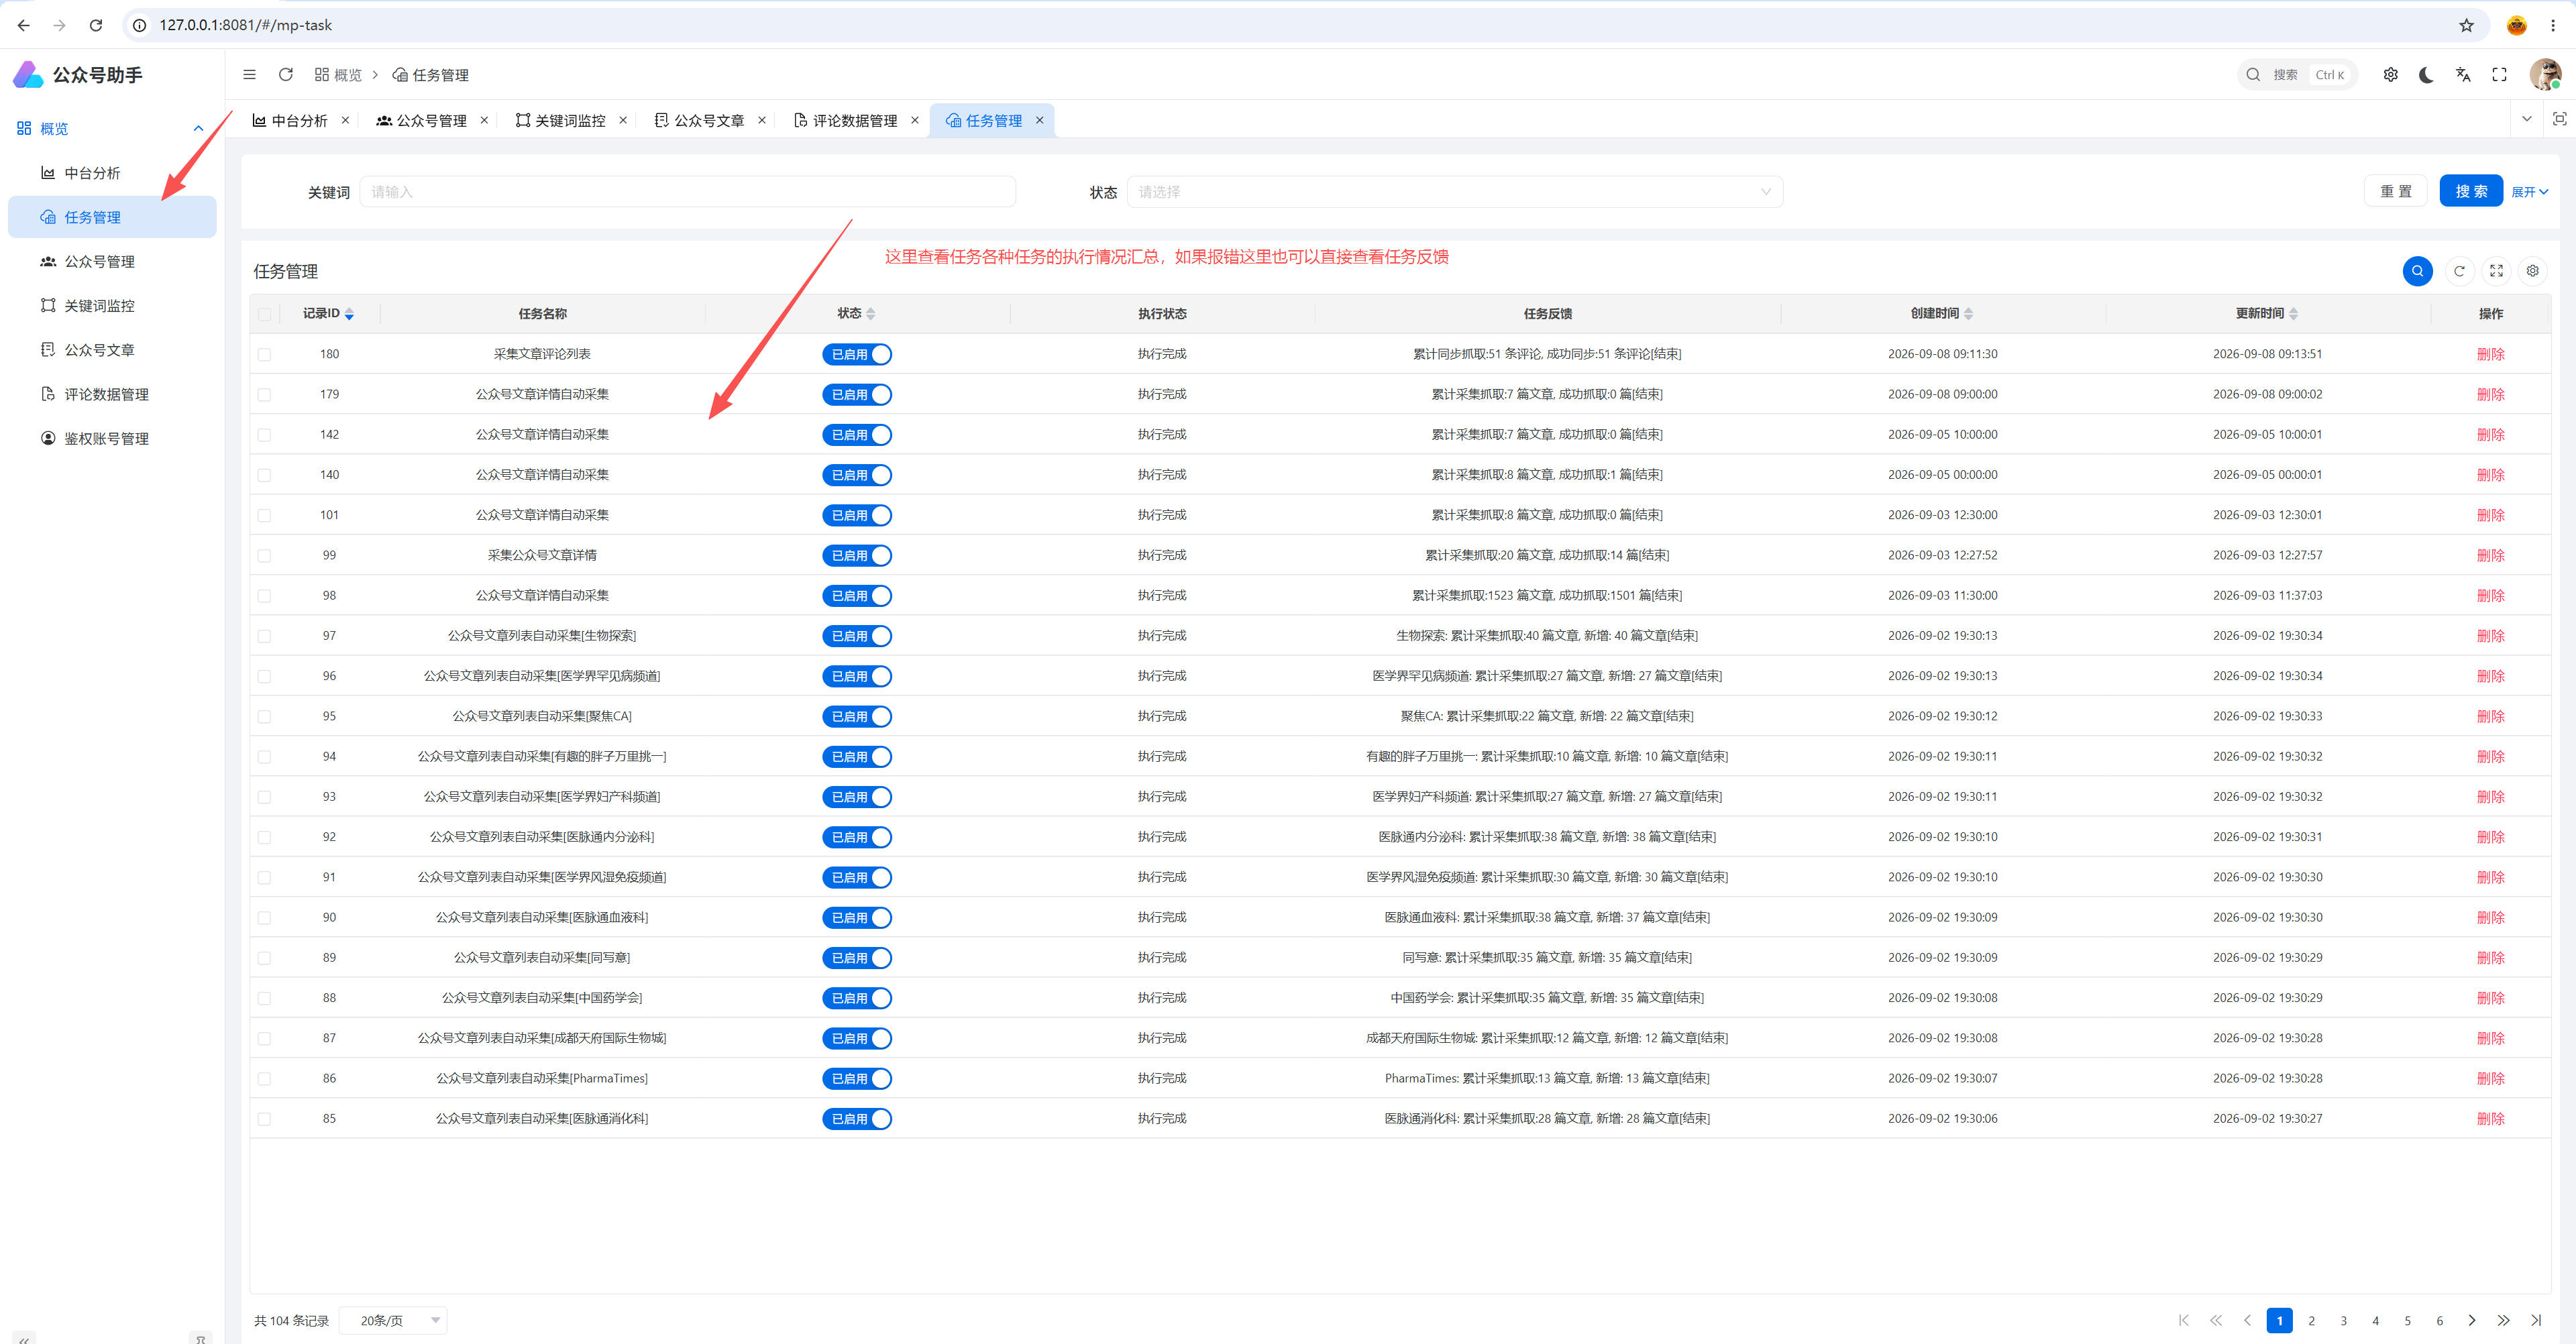
系统触发的采集任务会进入任务队列统一处理。任务管理页面用于查看每个任务的进度、状态和执行结果。
- 可查看任务的执行状态、处理进度和返回结果。
- 如果某个任务不再需要执行,可在页面中删除并清理。
- 当采集量较大时,建议通过任务状态判断是否需要调整采集频率或拆分采集范围。